把需求说清楚,让 WorkBuddy 更准确地理解、执行和反馈。
1.1工作原理速览:看懂 LLM 怎么「想」
- 为什么说 LLM 本质是"预测下一个词"?这和输入质量有什么关系?
- Token、上下文窗口、温度、幻觉分别是什么?
- 三种模式底层的权限有什么差异?怎么选对模式?
一、术语说明:什么是 Prompt
在你继续往下读之前,先认识一个贯穿本章的关键词。
Prompt(提示词) = 你输入给 AI 的那段文字。在 WorkBuddy 里,就是你打在输入框里发给 AI 的内容。
说人话就是:你告诉 AI 要做什么的那句话。后面的「上下文」「Token」「温度」都是围绕「怎么让这句 Prompt 更精准」展开的。
二、一个关键认知:LLM 不是「理解」,是「预测」
大语言模型本质上做的事只有一件:拿到你给的 Prompt,猜接下去该输出什么词。
你输入:「今天天气真」

模型预测下一个 token 的概率:
  不错 ████████ 38%
  好   ██████   27%
  热   ███      14%
  ...
这意味着:
- 你给的上下文越多、越具体 → 概率分布越集中 → 答案越精准
- 你给的上下文越模糊 → 概率分布越发散 → 答案靠运气
用一个类比理解:
| 你说的话 | 结果范围 | 效果 |
|---|---|---|
| 「做个菜」 | 中餐?西餐?荤?素? | 什么都可能端上来 |
| 「做一道素菜」 | 缩小到素食 | 可能是炒青菜、凉拌黄瓜… |
| 「用青椒和土豆做家常菜,微辣,两人份」 | 精确到具体菜谱 | 青椒土豆丝,辣度和量刚好 |
结论:模糊的输入,输出的不确定性就大——你可能运气好撞上一个好答案,但靠运气不如靠指令。精准的输入,输出的可控性就强。
三、Token:LLM 的「最小处理单位」
Token 可以理解为 AI "嚼"文字的最小一口。"人工智能"四个字,AI 不是一个个字读的,而是一两字一口地嚼——[人工]一口,[智能]一口,两口就嚼完了。不同模型的"嚼法"不一样,所以同样一段文字,不同模型算出来的 Token 数会有差异。
通用参考规则:
- 中文:约 1-2 个汉字 = 1 Token(取决于分词器)
- 英文:约 0.75 个词 = 1 Token
- 代码:1 个符号/关键字可能 = 1 Token
| 示例 | Token 拆分 | Token 数 |
|---|---|---|
| 「人工智能」 | [人工] [智能] | 2 |
| 「WorkBuddy 是 AI 助手」 | [Work][Bud][dy][是][AI][助手] | 6 |
分词规则直接影响模型对语义的理解效果。中文因存在多音字、词组组合特性,分词规则比英文更细致。不同模型(如 BERT、GPT)的分词逻辑存在差异。
为什么要关心 Token?
- LLM 有上下文窗口上限(输入 + 输出总 Token 数有限)
- 上传一个 50 页 PDF 可能消耗数万 Token → 剩下的聊天空间就少了
- 对策:文件太大时分批处理,长对话太久时开新会话
四、上下文窗口与记忆机制:LLM 的「短期记忆」
LLM 没有真正「记住」历史对话,而是把整个对话历史一直带在上下文窗口里。但 WorkBuddy 有额外的记忆系统来增强长期记忆能力。
(一)上下文窗口(短期记忆)
第 1 轮:[用户: 我是某公司 HR] → LLM 看到 1 条
第 5 轮:[用户:...] [AI:...] × 5 → LLM 看到全部 5 轮
第 N 轮:窗口塞满 → 最早的信息被截断("我是 HR"可能已看不见)
上下文窗口的限制:
- 窗口大小有限(各模型的上下文窗口上限不同,主流模型通常为数十万 Token 级别,部分模型支持百万级超长上下文)
- 窗口塞满后,最早的信息会被截断
- 超长对话会导致早期关键信息被稀释
(二)WorkBuddy 记忆系统(长期记忆)
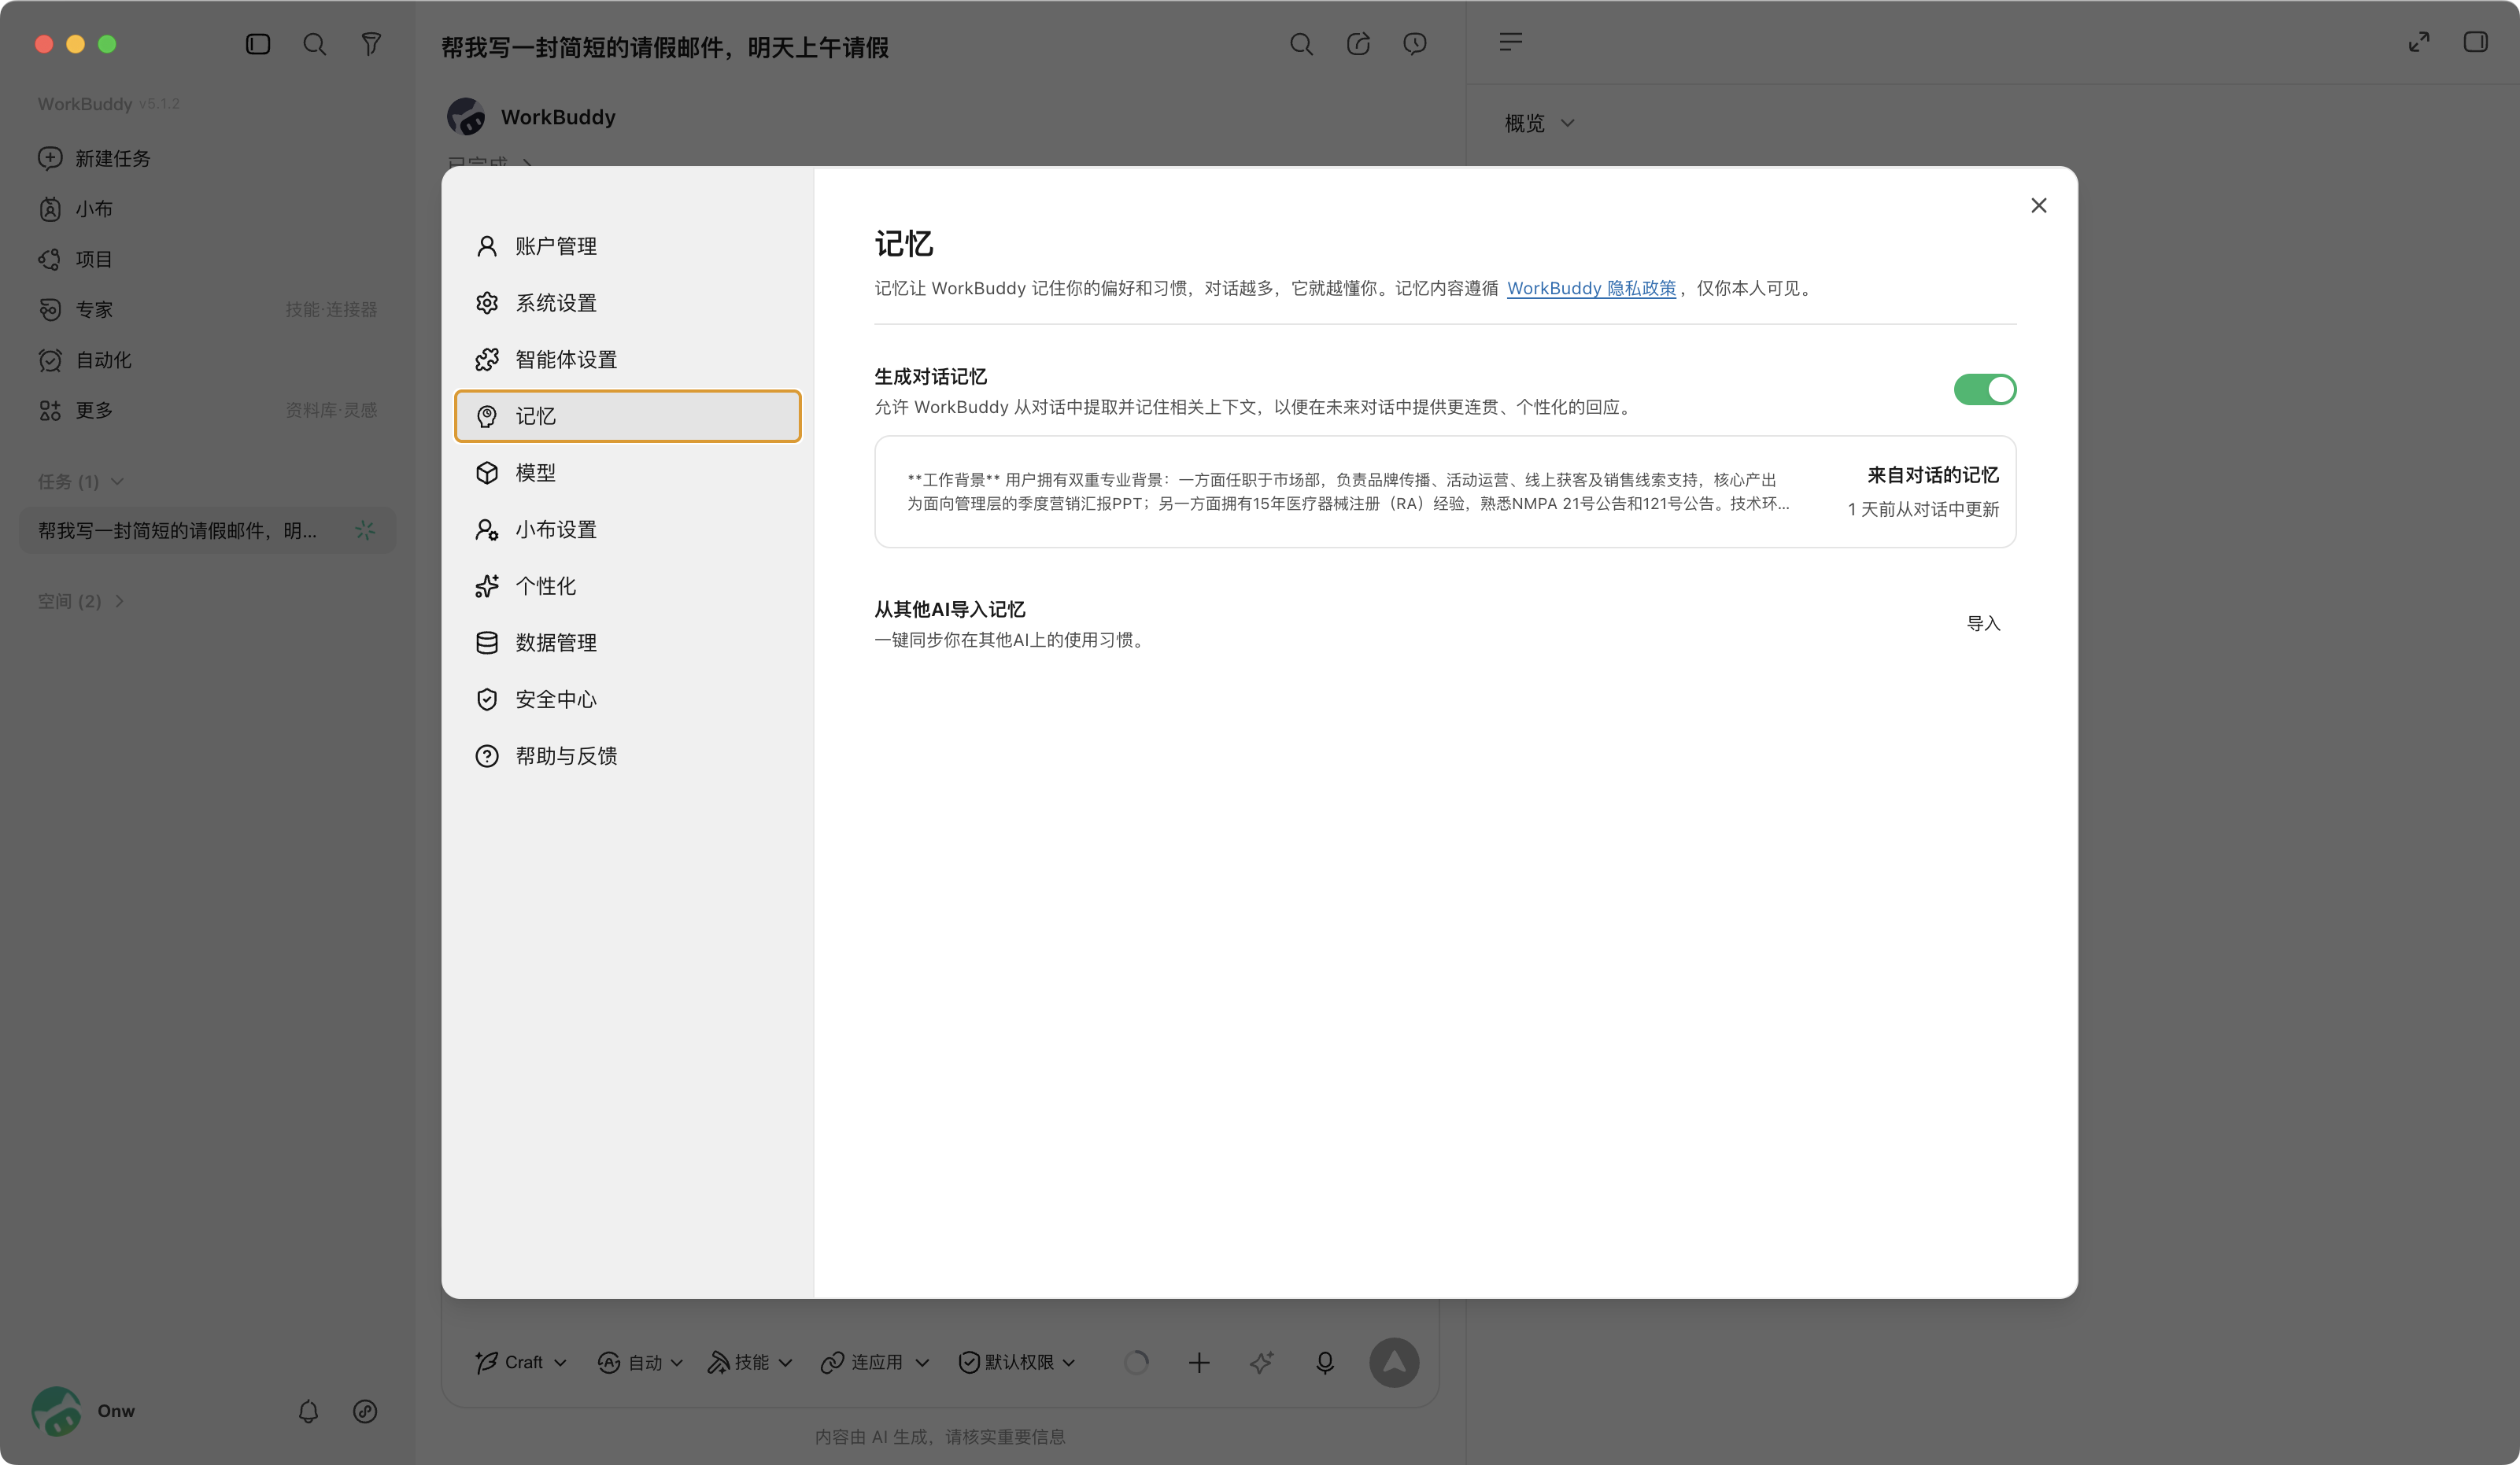
WorkBuddy 有三层记忆架构,让 AI 真正「记住」你:
| 记忆层级 | 存储位置 | 作用域 | 内容类型 |
|---|---|---|---|
| 云端记忆 | 服务端 | 跨设备 | 用户画像、历史对话索引 |
| 本地记忆 | 用户主目录下的配置文件夹 | 跨项目 | 长期偏好设置、使用习惯、工具使用记录 |
| 工作空间记忆 | 当前项目的工作区目录内 | 当前项目 | 每日工作日志、项目笔记 |
记忆功能默认开启,系统每晚自动整理当日会话,从对话中提取事实信息、偏好习惯、人物关系等形成「记忆数据」。后续对话时,会将相关记忆作为背景信息注入。
对策:
- 新任务 → 开新会话,重置窗口
- 关键信息 → 通过「设置 → 记忆」管理,或对话中直接告诉 WorkBuddy「记住 XX」
- 长期使用 → 善用记忆系统,让 WorkBuddy 越来越懂你
五、温度:控制 LLM 的「创造力」
同一个 Prompt,两次可能得到不同答案。这是温度参数在起作用——这是 LLM 的通用机制,非 WorkBuddy 特有。
| 温度值 | 效果 | 比喻 |
|---|---|---|
| 低 | 稳定、保守、可预测 | 照本宣科的公务员 |
| 中 | 平衡创造性和可靠性 | 经验丰富的职场人 |
| 高 | 多变、有创意、不可控 | 天马行空的艺术家 |
Ask 模式默认中等温度;Craft 模式执行关键操作时可能自动降温度以减少出错。你通过「正式/简洁/友好」等语气指令,实质也是在间接影响输出的随机性。
六、幻觉:LLM 为什么会「一本正经地胡说」
幻觉(Hallucination)= LLM 编造了看起来合理但实际不存在的信息。
| 类型 | 示例 | 原因 |
|---|---|---|
| 事实性幻觉 | 编造一篇不存在的论文引用 | 概率预测碰到训练数据空白,最可能的词恰好是假的 |
| 逻辑性幻觉 | 「123 × 456 = 54321」 | LLM 不是计算器,在「猜」而不是「算」 |
| 来源性幻觉 | 给出打不开的链接 | 学了域名模式,不验证链接是否真实存在 |
对策:
- 联网搜索后必须点击链接验证
- 关键数据多来源交叉确认
- 不确定时追问「来源是什么?」
七、三种模式背后的本质
三种工作模式的底层差异,从架构视角看,在于权限级别和执行逻辑:
| 模式 | 权限级别 | 执行逻辑 |
|---|---|---|
| Ask | 只读,不操作文件 | 单次推理,无工具调用 |
| Plan | 只读 → 用户确认后解锁写入 | 五阶段工作流(见下方详解) |
| Craft | 全权限,可读写文件 | Agent 自主循环迭代 |
Plan 模式的五阶段工作流
Plan 模式的核心是将「规划」作为一等公民,解决传统 AI 直接执行导致的偏差和返工问题:
- 需求澄清:AI 通过 1-2 轮关键问题对齐需求边界(技术栈、功能范围、项目约束等)
- 方案生成:基于确认的需求生成完整方案(需求分析、技术方案、视觉设计、任务清单)
- 编辑确认:用户可调整方案,执行前纠偏,避免后期重构
- 方案执行:按任务清单逐步执行,实时反馈进度,支持暂停调整
- 方案归档:自动保存为 Markdown 文件到项目的计划文件夹中,可作为项目知识库复用
架构级改动用 Plan(先规划后执行),细节级调整用 Craft(快速响应)。两者可灵活切换,并非互斥关系。
模糊 vs 精准:三组对比
| 模糊指令 | 精准指令 | 差距在哪 |
|---|---|---|
| 「帮我写周报」 | 「我是销售部员工,本周完成3个客户拜访+1个签约(50万)。按『本周产出/数据/下周计划』三部分写。」 | 缺角色、缺数据、缺格式 |
| 「分析这个数据」 | 「附件是Q1-Q3销售数据,分析各月趋势、环比增长率、TOP3产品,输出表格+2条建议。」 | 缺范围、缺维度、缺输出要求 |
| 「做个 PPT」 | 「把这份 Word 大纲转成 PPT,蓝色商务风格,每页不超过5个要点,加公司 Logo。」 | 缺素材、缺风格、缺约束 |
核心要点回顾
- LLM 本质是预测下一个词 → 输入越精准,输出越可控
- Token 有限、上下文有窗口 → 文件大了分批,聊多了开新会话
- 温度控制创造力,幻觉需要验证 → 关键信息必须核实来源
- Ask 只答、Plan 先审、Craft 直接干 → 底层是权限开关的区别,选对事半功倍
实战挑战(5 分钟)
挑一条你最近发给 AI 的模糊指令,按「角色 + 背景 + 任务 + 格式」补全成精准指令,重新发一次,对比两次输出差在哪里。
1.2Prompt 心法:从会说人话到会问 AI
- Prompt 的结构是什么?怎么快速构建高质量提问?
- 怎么通过追问逐步逼近最佳答案?
- 怎么控制 AI 的输出语气,让它符合场景需求?
一、Prompt 结构:角色 + 背景 + 任务 + 格式
一个高效的 Prompt 应包含四个要素。结构化的指令能让 AI 更精准地理解你的需求,显著提升输出质量。
| 要素 | 含义 | 作用 | 重要性 |
|---|---|---|---|
| 角色 | 你是谁,在什么岗位/场景下 | 让 AI 代入你的视角,输出更贴合 | 高 |
| 背景 | 相关限制条件和上下文信息 | 让 AI 理解具体情况,避免泛泛而答 | 高 |
| 任务 | 你想要 AI 做什么(指令) | 明确任务方向,这是最关键的一步 | 高 |
| 格式 | 希望得到什么形式的输出 | 控制输出结构,便于直接使用 | 中 |
示例:撰写会议纪要
- 角色:我是产品部项目助理
- 背景:今天下午 2 点开了产品评审会,参会人员包括产品部张经理、研发部李工、测试部王工
- 任务:整理成会议纪要,重点记录讨论要点和决议事项
- 格式:按「会议基本信息→讨论要点→决议事项→待办跟进」结构输出,每个部分用 bullet point
组合后:「我是产品部项目助理。今天下午 2 点开了产品评审会,参会人员包括产品部张经理、研发部李工、测试部王工,讨论了 3 个需求的优先级排序。请帮我整理成会议纪要,按『会议基本信息→讨论要点→决议事项→待办跟进』的结构输出,每个部分用 bullet point。」
二、Prompt 优化三阶段
优化 Prompt 分三步走:
| 阶段 | 操作 | 说明 | 示例 |
|---|---|---|---|
| 第一阶段:搭骨架 | 明确角色 + 背景 + 任务 + 格式 | 保证 AI 理解不跑偏 | 「我是 HR,需要一份新员工入职培训计划,按周输出,用表格呈现。」 |
| 第二阶段:加约束 | 补充字数、风格、禁止事项、输出要求 | 缩小 AI 的发挥空间,提升精准度 | 「... 500 字以内,正式语气,不包含薪酬具体数字。」 |
| 第三阶段:给范例 | 提供一个参考样本或输出模板 | AI 模仿效果通常比描述更精准 | 「... 参考这个格式:第 1 周:入职手续(事项 A/B/C)」 |
三、追问五种策略
追问是提升 AI 输出质量最有效的手段,以下五种策略最常用:
| 策略 | 适用场景 | 追问示例 | 效果 |
|---|---|---|---|
| 要求细化 | 回答太笼统、缺细节 | 「第 2 点能否展开,给出具体执行步骤?」 | 补充细节和实操指引 |
| 换个角度 | 需要多视角、评估风险 | 「如果预算砍半,方案怎么调整?」 | 获得备选方案和风险评估 |
| 请求举例 | 理论太多、不好落地 | 「用我们行业的实际业务场景举个例子。」 | 理论落地,更易执行 |
| 质疑验证 | 需要判断可靠性、查漏 | 「这个方法有什么潜在风险?」 | 发现盲点,完善方案 |
| 格式转换 | 需要不同输出形式 | 「把刚才的内容整理成表格/PPT 大纲。」 | 直接产出可用格式 |
对话太长时开新窗口。AI 的上下文窗口有限制,对话越长,早期信息可能被截断。适时开新会话,重置窗口。但别忘了 WorkBuddy 的记忆系统可以跨会话保留你的偏好和习惯。
追问实战:四轮对话步步逼近(以"制定季度工作计划"为例)
| 轮次 | 提问 | 效果 |
|---|---|---|
| 第 1 轮 | 「我是市场部经理,需要制定 Q4 工作计划,团队 5 人,重点在品牌推广和活动策划。」 | 得到框架方案 |
| 第 2 轮 | 「第 2 点(品牌推广)细化到具体平台和月度节奏。」 | 补充执行细节 |
| 第 3 轮 | 「如果其中 1 人临时支持其他项目,人员如何调整?」 | 增加风险预案 |
| 第 4 轮 | 「整理成可直接向总监汇报的 PPT 大纲,每页用 bullet point。」 | 格式落地 |
四、语气控制:给 AI 注入「人设」
同一件事,语气不同,效果完全不同。语气指令是控制 AI 输出风格最直接的手段。
| 语气类型 | 适用对象 | 指令关键词 | 示例场景 |
|---|---|---|---|
| 正式商务 | 客户、领导、合作伙伴 | 「用正式、专业的语气」 | 给客户的方案邮件 |
| 友好亲切 | 同事、团队内部 | 「用轻松、友好的语气」 | 团队通知、内部沟通 |
| 简洁直接 | 紧急事务、快速同步 | 「用简洁、直接的语言」 | 项目进度同步、问题反馈 |
| 委婉礼貌 | 拒绝请求、提出建议 | 「用委婉、礼貌的方式」 | 拒绝需求、提出改进建议 |
同一件事,四种语气对比(通知团队周末支持项目):
- 简洁直接:「各位,本周六需支持 XX 项目上线,请提前安排时间。」
- 友好亲切:「Hi 团队,这周六咱们一起保障 XX 项目上线,辛苦大家!中午订餐,晚上庆功~」
- 正式商务:「各位同事,兹通知本周六需全员支持 XX 项目上线,请提前协调个人安排并确认到岗时间。」
- 委婉礼貌:「不好意思周末打扰大家,XX 项目上线在即,需要各位支持。周六方便到岗的同事请回复确认,辛苦了。」
语气指令可以叠加。例如「用正式但不过于刻板的语气」或「用简洁但直接且不冒犯的语气」,能更精准地控制输出风格。
核心要点回顾
- Prompt 结构:角色 + 背景 + 任务 + 格式 → 结构化指令让 AI 精准理解
- 三分法优化路径:搭骨架(明确指令)→ 加约束(缩小发挥空间)→ 给范例(提升模仿效果)
- 追问策略:细化、换角度、要举例、质疑验证、格式转换 → 迭代逼近最佳答案
- 语气控制:正式商务 / 友好亲切 / 简洁直接 / 委婉礼貌 → 一句话切换输出风格
新任务先开新会话;长对话定期提醒 AI 关键信息;日常工作中养成记录习惯,方便周末汇总时快速生成周报。
核心技法速查
| 技法 | 一句话 | 使用时机 |
|---|---|---|
| 角色扮演 | 「你是一名资深 XX 专家」 | 需要专业视角时 |
| 苏格拉底追问 | 不停追问「为什么」层层深入 | 分析复杂问题根因 |
| 预演失败 | 「如果这个方案失败了,最可能的原因是什么?」 | 方案评审、风险评估 |
| 渐进提炼 | 先出框架 → 逐步细化每个模块 | 复杂方案写作 |
| 反向提示 | 「不要写成 XX 风格」「避免使用 XX 词汇」 | 控制输出方向 |
| 跨领域创新 | 「用 XX 行业的思路解决 YY 问题」 | 创意策划 |
所谓"激励式表达"会影响 AI 的措辞选择和分析深度。虽然 AI 没有情绪,但给高质量要求的暗示(如"请深思熟虑后给出专业建议")能提升输出质量。
五个必须避开的坑
| 坑 | 表现 | 正确做法 |
|---|---|---|
| 坑1:指望一次成功 | 写一个长 Prompt 等完美答案 | 先用短 Prompt 跑出框架,再追问迭代 |
| 坑2:盲目信任 | 直接使用未核实的搜索结果 | 关键数据点击原链确认,多方交叉验证 |
| 坑3:模式选错 | 用 Ask 模式要求 AI 生成文件 | 需要操作文件时切 Craft 或 Plan |
| 坑4:上下文超载 | 一个会话聊几十轮不换 | 新任务开新会话,长任务定期提醒关键信息 |
| 坑5:指令太抽象 | 「帮我做得好一点」「更专业些」 | 给具体标准:「控制在 200 字」「用表格呈现」 |
实战挑战(5 分钟)
选一段你常用的提问,套用「搭骨架 → 加约束 → 给范例」三步优化一遍,再追问一轮,看看输出质量提升了多少。
1.3场景实战:高频工作示例
- 四个典型场景(文档处理、内容写作、数据分析、联网搜索)各自怎么套公式写指令?
- 怎么把学到的 Prompt 心法举一反三用到更多场景?
- 为什么搜索后要验证?怎么验证?
一、文档处理
上传文件后,用自然语言告诉 AI 要做什么。以下场景覆盖多个行业岗位:
| 场景 | 岗位 | 指令示例 |
|---|---|---|
| 合同审阅 | 法务 | 「上传这份采购合同,提取甲乙双方权利义务,标注不对称条款和潜在风险」 |
| 简历筛选 | HR | 「上传这 20 份简历 PDF,提取每人的工作经验年限和核心技能,按岗位匹配度排序」 |
| 财报分析 | 财务 | 「上传这份年度财务报表,分析毛利率变化趋势,列出同比变动超 10% 的项目」 |
| 论文精读 | 教师/研究员 | 「用 500 字总结这篇论文的创新点和实验结论,指出研究局限性」 |
完整案例:
- 上传一份技术方案 PDF
- 输入:「总结核心架构、主要功能和实施计划,列出 3 个风险点」
- 查看结果,追问:「把实施计划细化到月,加甘特图」
二、内容写作
写作指令公式:文档类型 + 目的 + 关键信息 + 语气要求 + 篇幅约束
| 场景 | 岗位 | 指令示例 |
|---|---|---|
| 招聘 JD | HR | 「帮我写一份高级 Java 工程师的招聘 JD,要求 5 年以上经验,熟悉微服务架构,附福利说明,500 字,语气专业但不刻板」 |
| 活动方案 | 市场/运营 | 「写一份 Q3 线上线下联动推广方案,预算 20 万,目标拉新 5 万,包含渠道策略和时间排期表」 |
| 公文通知 | 行政/政府 | 「起草一份关于公司年度消防演练的通知,时间下周三下午 3 点,全员参与,语气正式规范」 |
| 客户邮件 | 销售 | 「帮我写一封给客户的跟进邮件,对方上次看了报价后 7 天未回复,语气委婉,不超过 200 字」 |
| 年终总结 | 管理层 | 「我是区域销售总监,帮我写年度工作总结,包含业绩回顾、团队建设、市场分析和明年规划四大板块」 |
三、数据分析
上传 Excel / CSV 文件后,按「数据范围 + 分析目标 + 输出要求」的结构下指令:
| 场景 | 岗位 | 指令写法 |
|---|---|---|
| 费用分析 | 财务 | 「分析各部门 Q1 差旅费,对比预算偏差率,标出超预算 20% 以上的部门,输出预警表格」 |
| 考勤统计 | HR | 「统计 3 月全勤人数、迟到次数分布和加班 TOP10,生成带图表的数据简报」 |
| 业绩分析 | 销售 | 「按区域分组统计季度销售额,计算环比增长率,用柱状图对比,标注 TOP3 和末 3 位」 |
| 用户分析 | 运营 | 「分析用户注册数据,按渠道拆解转化率,找出转化最高的 3 个渠道并给优化建议」 |
完整链路:
- 上传数据文件(确保第一行是表头)
- 输入分析指令 → AI 处理(10-30 秒)
- 查看结果 → 如需调整,追问「换成饼图」「按区域再分一组」
- 满意后下载图表和报告
四、联网搜索
指令公式:搜索主题 + 信息范围 + 时间限定 + 输出格式
| 场景 | 岗位 | 指令要点 |
|---|---|---|
| 供应链调研 | 采购/制造业 | 「搜索 2026 年芯片供应链的产能状况和主要供应商,整理成评估报告,标注来源」 |
| 政策研究 | 法务/政府事务 | 「搜索 2025-2026 年数据安全相关法规更新,按时间线整理,标注影响范围和合规建议」 |
| 行业分析 | 金融/投资 | 「搜索 2026 年 AI 医疗行业的融资事件、头部公司和市场规模,整理成结构化报告」 |
| 竞品调研 | 产品/战略 | 「搜索主要竞品近 3 个月的功能更新和定价变化,按时间倒序整理成对比表格」 |
三步闭环:搜 → 验 → 整
- 搜:明确要求联网搜索,给出时间范围和信息维度
- 验:点击来源链接确认信息准确,多个来源交叉验证
- 整:要求 AI 按指定格式整理(表格 / 报告 / PPT 大纲),标注每条来源
AI 可能给出不存在的链接,发布前务必点击验证。关键数据建议多方交叉确认。
核心要点回顾
- 四个典型场景各有指令公式:文档(上传+指令)、写作(类型+目的+信息+语气)、数据(范围+目标+输出)、搜索(主题+时间+格式),这套思路可迁移到更多场景
- 搜 → 验 → 整三步闭环,联网搜索必须核实来源
- 追问迭代 + 语气控制,比一次写长 Prompt 更高效
实战挑战(5 分钟)
从文档、写作、数据、搜索四类场景中挑一个你本周真实的任务,套用对应的指令公式写一条 Prompt 并执行,记录哪里还需要追问补充。
本章总结
| 小节 | 要点 |
|---|---|
| 1.1 工作原理速览 | 看懂 LLM 怎么「想」——它基于概率续写、有上下文窗口与知识边界,理解机制才能用好它 |
| 1.2 Prompt 心法 | 从「会说人话」到「会问 AI」——用 Prompt 四要素把需求说清楚,让 AI 一次到位 |
| 1.3 场景实战 | 文档、写作、数据、搜索四类高频场景,各套一个指令公式快速上手 |
通过本章学习,你已经看懂了 LLM 怎么「想」、学会用 Prompt 四要素套场景公式,掌握了高效使用AI工具的核心对话技法。